Ein Agent hat mir 24 Werktage in Folge um 06:30 das Briefing geschrieben
Seit dem 1. September ist bei uns kein Morgenbrief ausgefallen. 24 Läufe, Montag bis Samstag, jeder um 06:30 Uhr. Der Agent liest über Nacht Gmail, das CRM und den Kampagnen-Stand in Lemlist, vergleicht das mit dem, was gestern im Vault stand, und legt eine Datei ab: Was ist neu, was ist die eine Sache für heute, welche Fragen sind offen.
Das ist kein Vorzeigeprojekt. Es ist der Teil unserer Agentur, der ohne Menschen läuft, und er ist der Grund, warum eine Link-Building-Agentur mit einem sehr kleinen Team drei Märkte bedienen kann. Dieser Text zeigt, wie das Team aufgebaut ist, welche Regel entscheidet, welches Modell welche Aufgabe bekommt, und wo es in drei Monaten Betrieb gebrochen ist. Am Ende steht die Startstruktur, die du morgen anlegen kannst.
Was ein KI-Marketing-Team wirklich ist
In den Videos, die gerade auf YouTube laufen, bekommt jeder Agent einen Vornamen und eine Stellenbeschreibung. Das ist ein guter Einstieg, aber es verdeckt, was das Team eigentlich ausmacht. Drei Dinge:
- Ein Ordner statt eines Prompts. Der Kontext liegt in Dateien: Regeln, Kundenprofile, Voice, Belegsätze mit Quelle. Jeder Agent liest denselben Ordner, bevor er arbeitet. Wer den Kontext in den Prompt tippt, erklärt jede Woche dieselben Vorlieben neu.
- Ein Zeitplan statt eines Chats. Die Agenten laufen ohne Aufforderung. Morgenbrief 06:30, Content-Lauf Montag 10:00, Publisher-Prüfung nachts. Ein Agent, den du starten musst, ist ein Werkzeug. Ein Agent, der dich morgens erwartet, ist ein Mitarbeiter.
- Eine Regel, wer entscheidet. Kein Agent sendet, postet oder bucht. Er legt eine Karte mit Optionen ab, ein Mensch wählt, die Entscheidung wird als Datei gespeichert. Bei uns heißt das Dauerregel 4: Nichts verlässt den Ordner ohne Freigabe.
Der Rest ist Rollenverteilung.
Die sechs Rollen
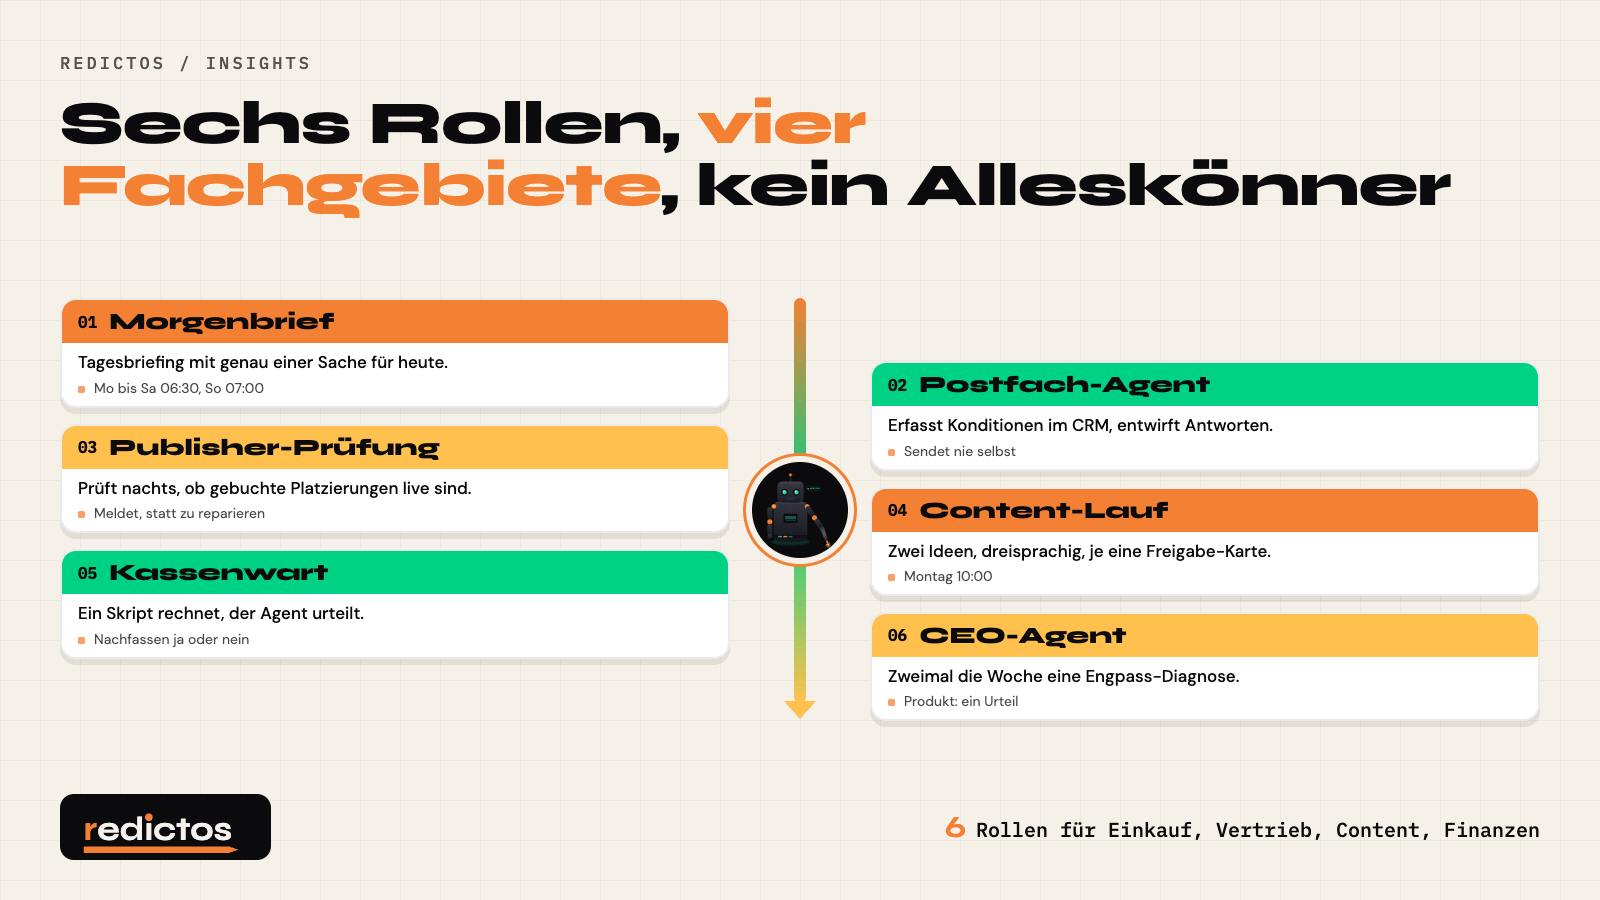
So sieht unser Team im September 2026 aus. Die Namen sind egal, die Zuschnitte nicht.
- Der Morgenbrief. Liest alle Eingangskanäle, schreibt das Tagesbriefing mit einer priorisierten Vorschlagsliste und genau einer Sache, die heute zuerst passiert. Läuft Montag bis Samstag 06:30, sonntags als Wochenrückblick um 07:00.
- Der Postfach-Agent. Geht durch Publisher-Antworten und Kundenanfragen, erfasst Konditionen im CRM, entwirft Antworten. Sendet nie selbst.
- Die Publisher-Prüfung. Kontrolliert nachts, ob gebuchte Platzierungen live sind und ob der Link noch so gesetzt ist wie bestellt. Meldet Abweichungen, statt sie zu reparieren.
- Der Content-Lauf. Montags: Ideen aus dem Wissensspeicher sammeln, zwei davon dreisprachig ausschreiben, für jedes Stück eine Freigabe-Karte anlegen. Der Text, den du gerade liest, ist so entstanden.
- Der Kassenwart. Ein Skript rechnet Zahlungsstände aus, der Agent liest die Mailfäden dazu und entscheidet je Zeile, ob nachgefasst wird. Der Agent rechnet nicht, er urteilt.
- Der CEO-Agent. Zweimal die Woche eine Engpass-Diagnose: Wo in der Wertkette hakt es, und ist das der Engpass, der es wert ist, gelöst zu werden. Der einzige Agent, dessen Produkt ein Urteil ist.
Sechs Rollen, vier Fachgebiete: Einkauf, Vertrieb, Content, Finanzen. Kein Alleskönner. Jede Rolle hat einen Auslöser, eine Berichtspflicht und einen Ort, an dem ihr Ergebnis liegt.
Die Regel, die über das Modell entscheidet
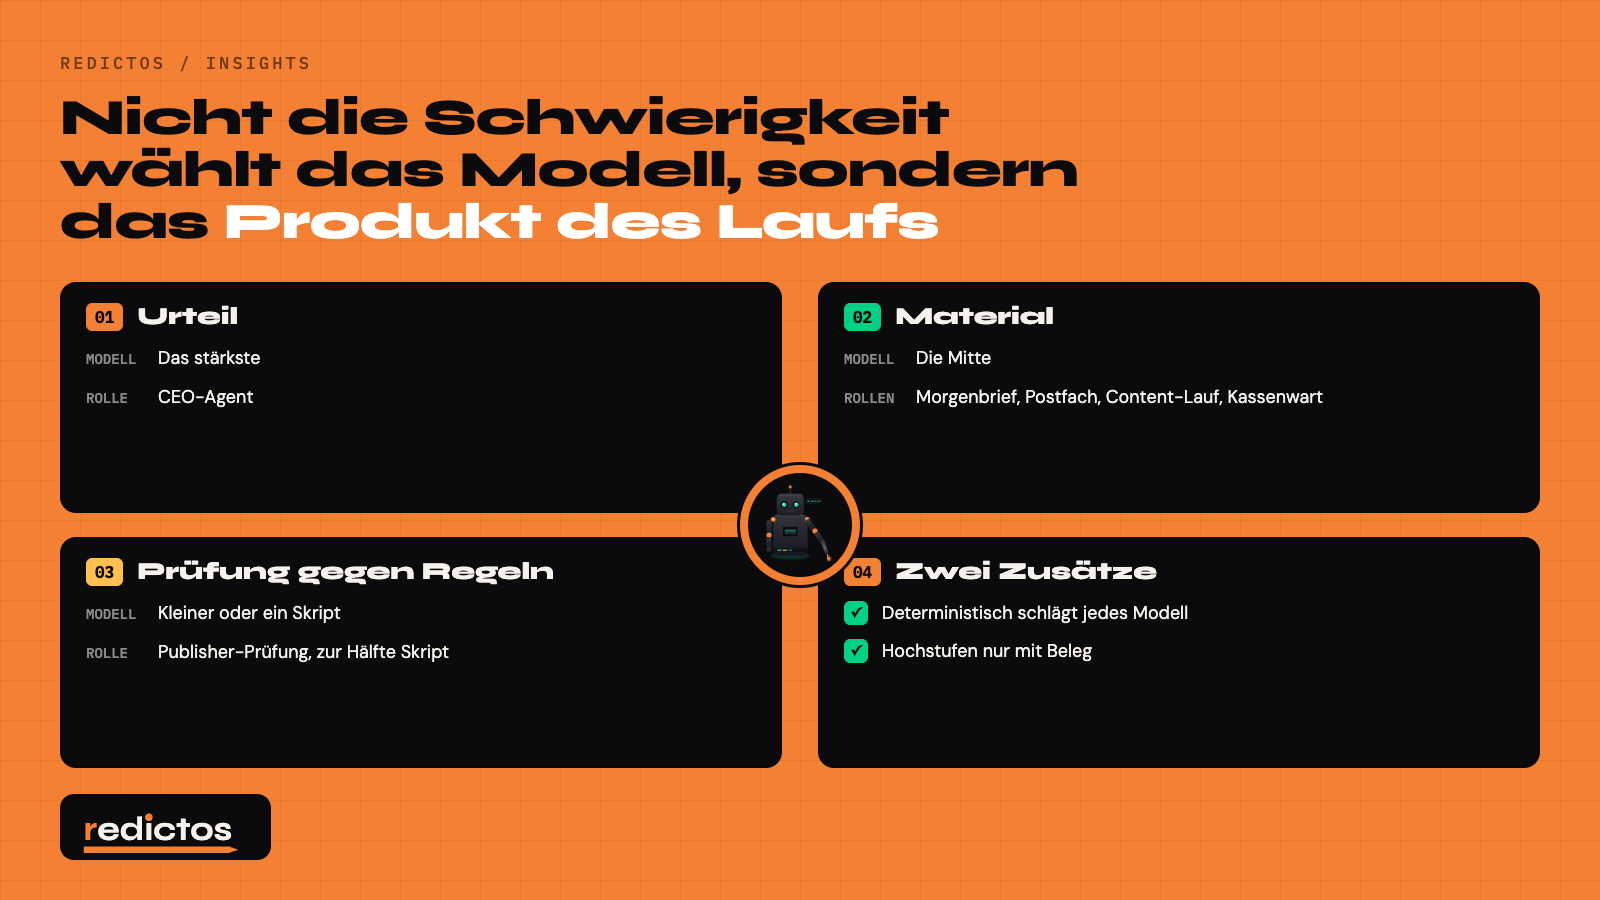
Die teuerste Frage bei einem Agententeam ist nicht, welches Modell das beste ist. Es ist die Frage, welches Modell welche Rolle bekommt. Unsere Regel steht seit dem 22. August in einer Notiz und hat sich seitdem nicht geändert:
Frage nicht, wie schwer die Aufgabe ist. Frage, was das Produkt des Laufs ist.
- Ist das Produkt ein Urteil, nimm das stärkste Modell. Das ist bei uns genau eine Rolle, der CEO-Agent.
- Ist das Produkt Material (ein Entwurf, eine Zusammenfassung, eine Sortierung), bleib in der Mitte. Morgenbrief, Postfach, Content-Lauf, Kassenwart laufen so.
- Ist das Produkt eine Prüfung gegen feste Regeln, geh runter. Oder ganz ohne Modell: Ein Skript im Cron schlägt jeden Agenten, wenn die Regel formalisierbar ist. Die Publisher-Prüfung ist zur Hälfte ein Skript.
Zwei Zusätze, die uns Geld gespart haben. Erstens: Deterministisch schlägt jedes Modell. Vor jedem Modellschritt prüfen wir, ob eine Abfrage, ein Filter oder ein Skript dasselbe liefert. Zweitens: Hochstufen nur mit Beleg. Nicht "das wirkt komplex", sondern "dieser Lauf hat X übersehen, hier ist die Stelle". Sonst wandert das ganze Team nach oben und die Rechnung mit ihm.
Wo es gebrochen ist
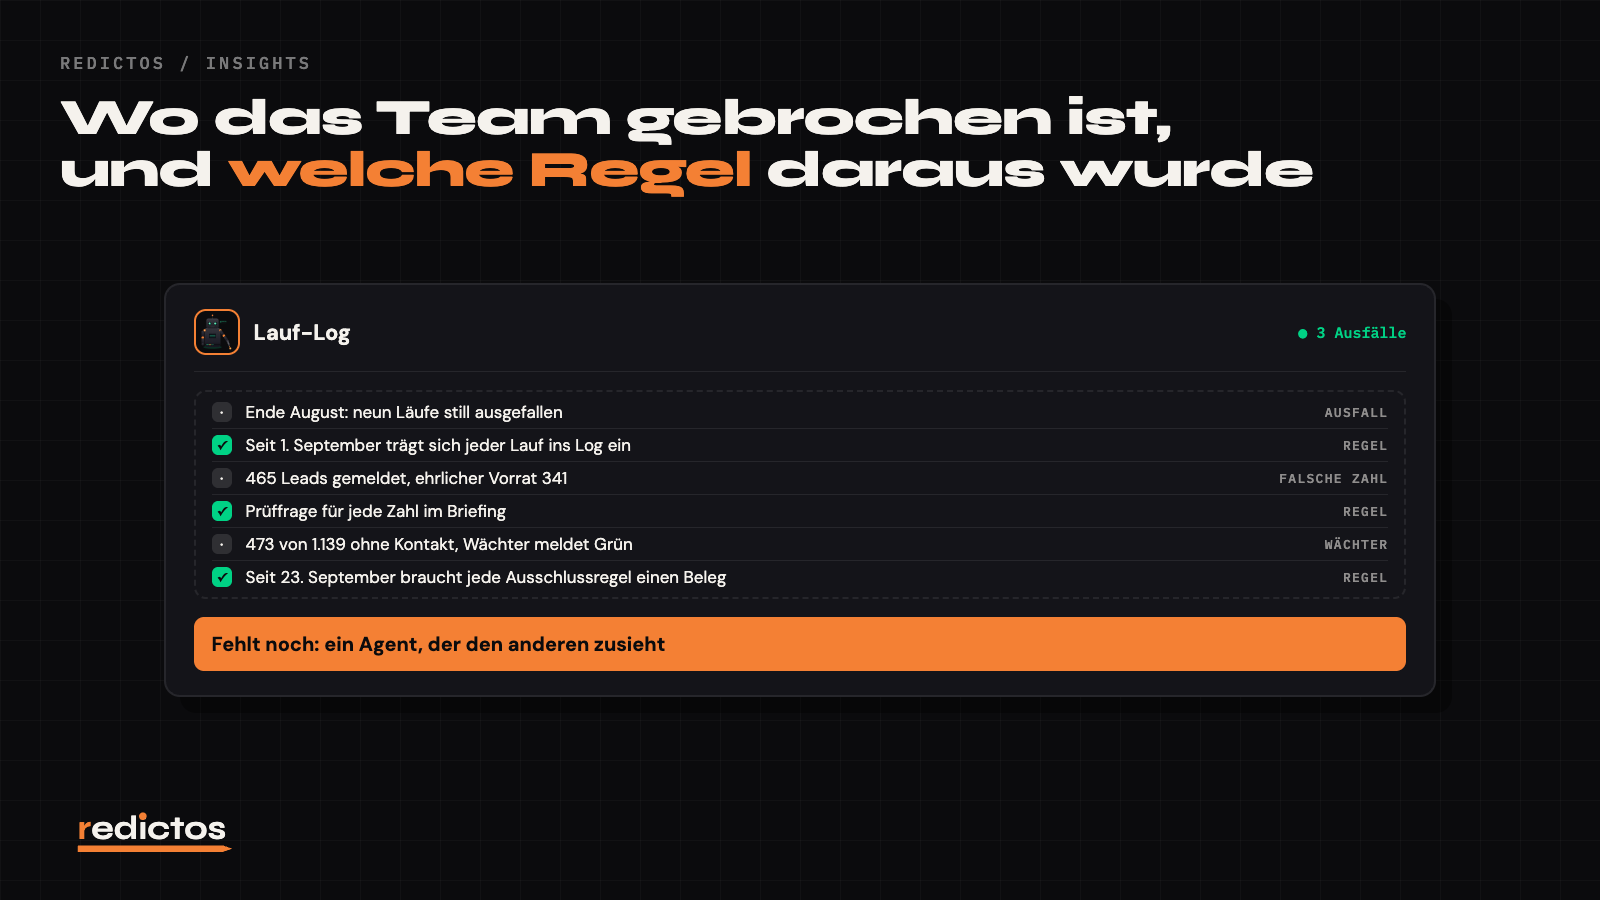
Ein Team, das drei Monate läuft, hat eine Ausfallgeschichte. Unsere in drei Punkten, weil sie die Bauregeln erklärt.
Neun Läufe stillschweigend ausgefallen. Der Morgenbrief lief im Sommer als Pilot. Ende August fiel er neun Tage hintereinander aus, und niemand merkte es, weil ein Agent, der nicht schreibt, keine Fehlermeldung schreibt. Seit dem 1. September hat jeder Lauf eine Berichtspflicht: Er trägt sich mit Zeitstempel in ein Log ein, auch wenn er nichts gefunden hat. Die 24 Läufe in Folge sind erst seit dieser Regel zählbar.
Eine Zahl, die drei Tage falsch war. Der Morgenbrief meldet den Lead-Vorrat der Kampagnen. Am 28. September zeigte er 465 freigegebene Leads. 124 davon lagen in pausierten Kampagnen und konnten nicht senden. Der ehrliche Vorrat war 341. Der Fehler fiel auf, als wir für jede Zahl im Briefing eine Prüffrage einführten: Was müsste noch jemand tun, damit diese Zahl stimmt? Ein Agent zählt richtig. Er weiß nur nicht, was zählt.
Ein Wächter, der jeden Tag "alles in Ordnung" meldete. Ein Prüfagent sollte veraltete Publisher-Kontakte melden und schloss dabei eine ganze Kategorie aus, weil im Quelltext eine Ausnahme stand, deren Begründung nicht mehr galt. Ergebnis: Von 1.139 Datensätzen dieser Kategorie hatten 473 seit über zwölf Monaten keinen Kontakt, und der Wächter meldete täglich Grün. Seit dem 23. September muss jede Ausschlussregel eines Wächters selbst einen Beleg tragen, wann sie zuletzt geprüft wurde.
Die Lektion aus allen drei: Ein Agententeam braucht keinen besseren Prompt. Es braucht einen Agenten, der den anderen bei der Arbeit zusieht und meldet, wo dieselbe Korrektur zum dritten Mal nötig war.
Die Startstruktur für morgen
Du brauchst kein Framework und keine Plattform. Du brauchst einen Ordner, sechs Einträge darin und einen Cron-Job.
- regeln.md: wer entscheidet, und was nie ohne Freigabe rausgeht.
- kontext/: Kundenprofil, Voice, Belegsätze mit Quelle. Das, was jeder Agent vor der Arbeit liest.
- agenten/morgenbrief.md: Auslöser, Quellen, Ausgabeformat, Berichtspflicht. Eine Datei je Rolle.
- inbox/: Karten mit Optionen, die ein Mensch entscheidet.
- entscheidungen/: beantwortete Karten, mit Datum und Begründung.
- log.md: eine Zeile je Lauf, auch bei "nichts gefunden".
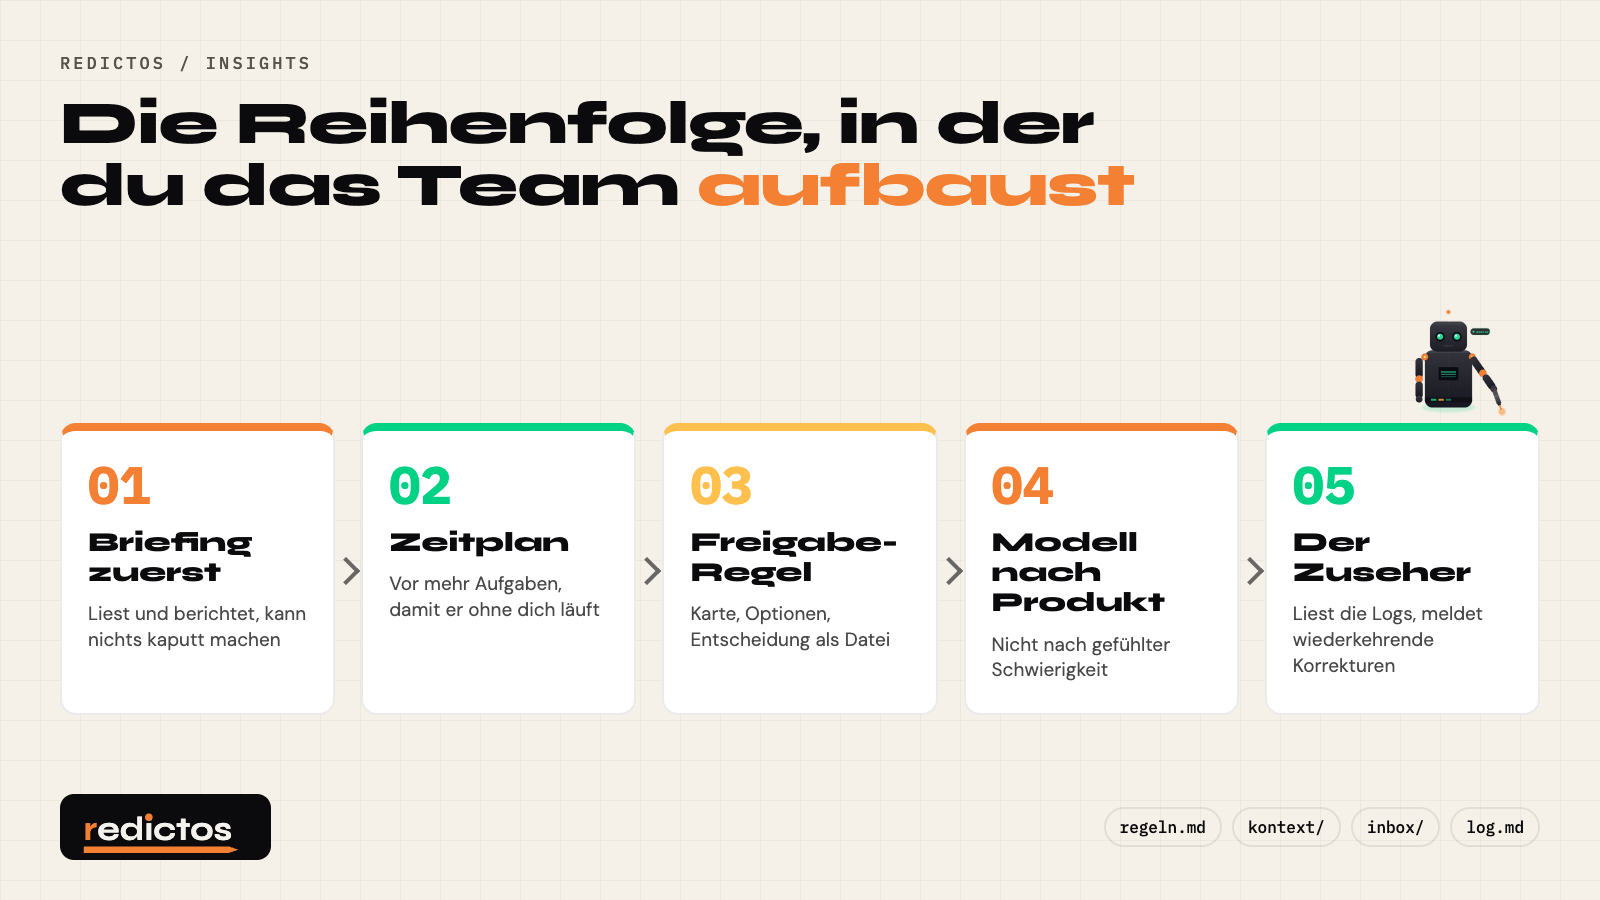
Und die Reihenfolge, in der du das Team aufbaust:
- Fang mit dem Briefing an, nicht mit dem Verkauf. Ein Agent, der nur liest und berichtet, kann nichts kaputt machen. Du lernst an ihm, wie dein Kontextordner aussehen muss.
- Gib ihm einen Zeitplan, bevor du ihm mehr Aufgaben gibst. Erst wenn er ohne dich läuft, ist er ein Teammitglied.
- Schreib die Freigabe-Regel, bevor der erste Agent etwas senden könnte. Karte, Optionen, Entscheidung als Datei. Das ist die eine Regel, die wir nie gelockert haben.
- Wähle das Modell nach dem Produkt des Laufs, nicht nach dem Gefühl für die Schwierigkeit.
- Bau den Zuseher als Zweites. Ein Agent, dessen einzige Aufgabe ist, das Log der anderen zu lesen und wiederkehrende Korrekturen zu melden.
Was wir noch nicht haben: den Zuseher. Er steht seit dem 31. August als offene Frage in unseren Notizen. Wenn er läuft, schreibe ich, was er in der ersten Woche gefunden hat.