Un agente me escribe el informe de la mañana desde hace 24 días laborables seguidos
Somos una agencia de link building que compra colocaciones en medios de España, Latinoamérica, Alemania e Italia. Tres mercados, cuatro idiomas de negociación, un equipo muy pequeño. Lo que hace posible esa cuenta es un grupo de agentes que trabaja de noche.
Desde el 1 de septiembre no ha fallado ni un informe matinal. 24 ejecuciones, de lunes a sábado, cada una a las 06:30. El agente lee durante la noche el correo, el CRM y el estado de las campañas en Lemlist, lo compara con lo que ayer quedó anotado en nuestra base de conocimiento y deja un archivo: qué hay de nuevo, cuál es la única cosa que toca hoy, qué preguntas siguen abiertas.
Este texto explica cómo está montado el equipo, qué regla decide qué modelo hace cada tarea, y dónde se rompió en tres meses de funcionamiento. Al final tienes la estructura inicial para montarlo mañana.
Qué es de verdad un equipo de marketing con IA
En los vídeos que circulan ahora en YouTube, cada agente lleva nombre propio y una descripción de puesto. Es un buen punto de partida, pero tapa lo que de verdad hace al equipo. Son tres cosas:
- Una carpeta en vez de un prompt. El contexto vive en archivos: reglas, perfiles de cliente, tono, frases de prueba con su fuente. Cada agente lee la misma carpeta antes de trabajar. Quien mete el contexto en el prompt está explicando cada semana las mismas preferencias.
- Un horario en vez de un chat. Los agentes se ejecutan sin que nadie los llame. Informe a las 06:30, producción de contenido los lunes a las 10:00, revisión de publishers de noche. Un agente que tienes que arrancar es una herramienta. Un agente que te espera por la mañana es un compañero de equipo.
- Una regla sobre quién decide. Ningún agente envía, publica ni reserva. Deja una tarjeta con opciones, una persona elige y la decisión se guarda como archivo. En casa lo llamamos regla permanente 4: nada sale de la carpeta sin aprobación.
El resto es reparto de papeles.
Los seis papeles
Así es nuestro equipo en septiembre de 2026. Los nombres dan igual. Los cortes, no.
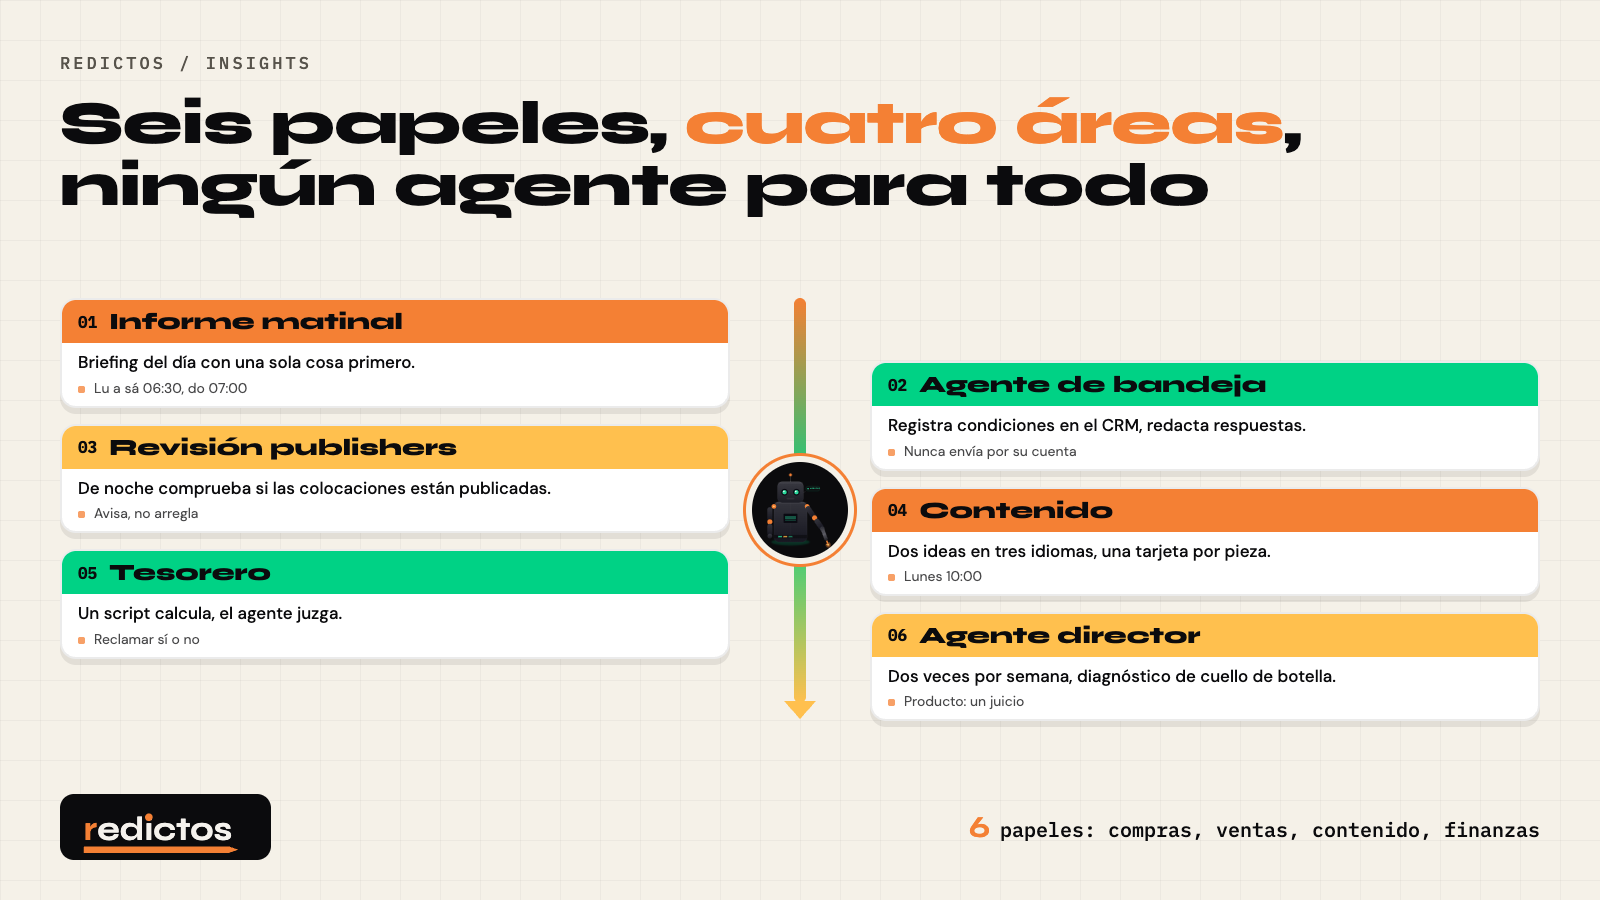
- El informe matinal. Lee todos los canales de entrada, escribe el briefing del día con una lista priorizada de propuestas y una sola cosa que se hace primero. De lunes a sábado a las 06:30, los domingos como repaso semanal a las 07:00.
- El agente de bandeja. Repasa respuestas de publishers y consultas de clientes, registra condiciones en el CRM, redacta respuestas. Nunca envía por su cuenta.
- La revisión de publishers. Comprueba de noche si las colocaciones reservadas están publicadas y si el enlace sigue como se pidió. Avisa de las desviaciones en vez de arreglarlas.
- La producción de contenido. Los lunes: recoger ideas de la base de conocimiento, redactar dos en tres idiomas, abrir una tarjeta de aprobación por pieza. El texto que estás leyendo salió así.
- El tesorero. Un script calcula los estados de cobro, el agente lee los hilos de correo y decide línea por línea si se reclama. El agente no calcula, juzga.
- El agente director. Dos veces por semana, un diagnóstico de cuello de botella: dónde se atasca la cadena de valor y si ese atasco merece resolverse. El único agente cuyo producto es un juicio.
Seis papeles, cuatro áreas: compras, ventas, contenido, finanzas. Ningún agente para todo. Cada papel tiene un disparador, la obligación de informar y un sitio donde deja su resultado.
La regla que decide el modelo
La pregunta cara en un equipo de agentes no es cuál es el mejor modelo. Es qué modelo recibe qué papel. Nuestra regla está escrita en una nota desde el 22 de agosto y no ha cambiado:
No preguntes cuánto cuesta la tarea. Pregunta cuál es el producto de la ejecución.
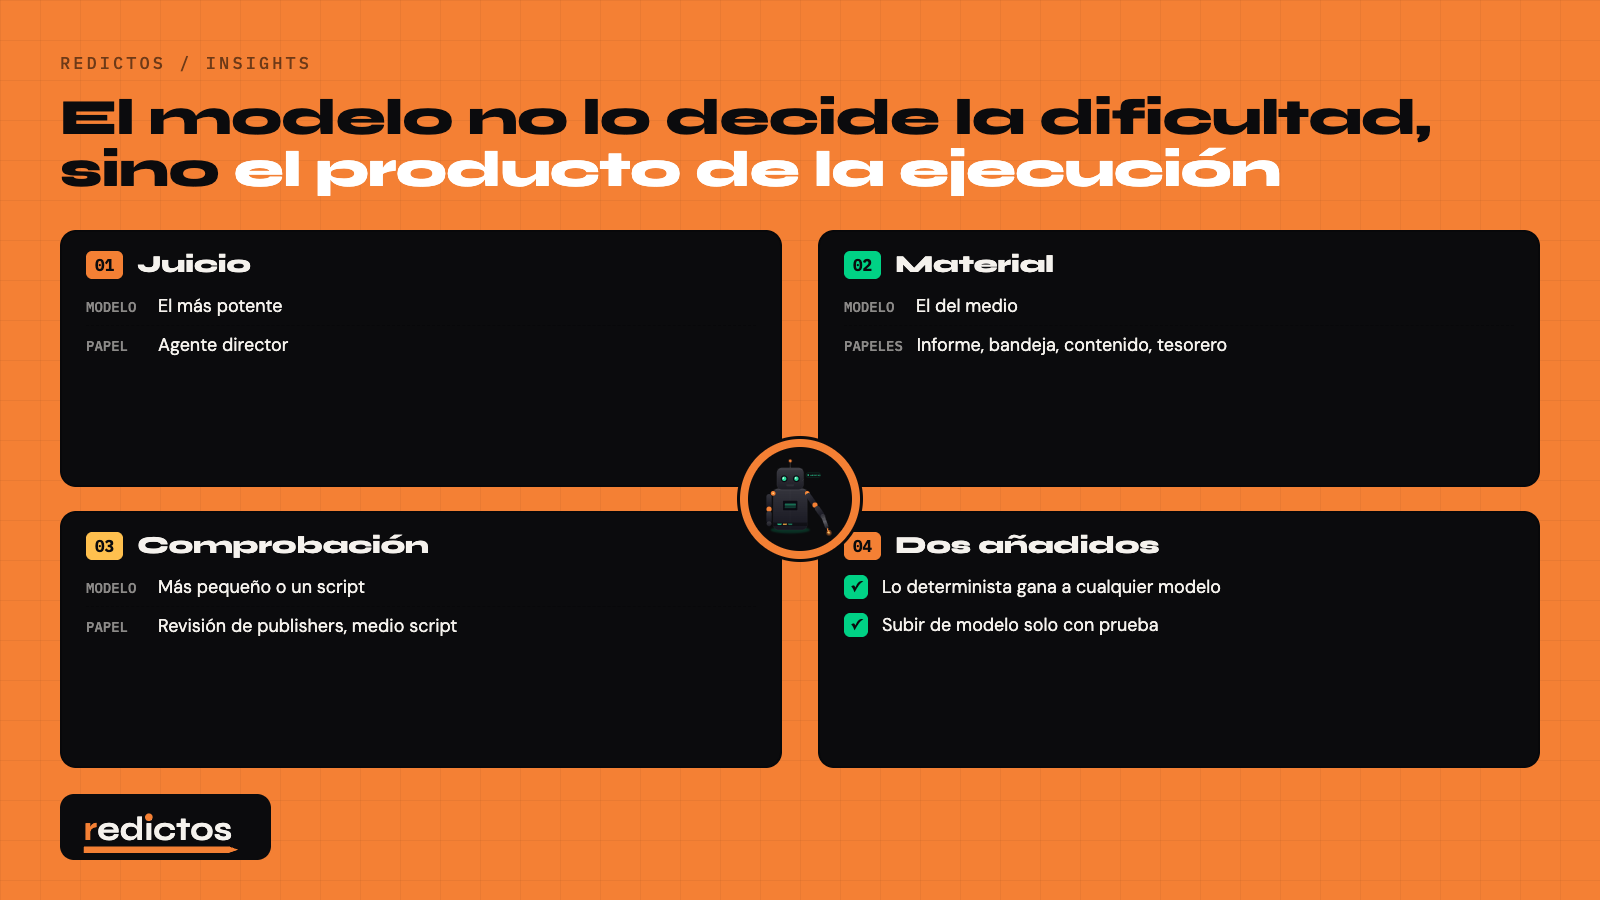
- Si el producto es un juicio, usa el modelo más potente. En casa es exactamente un papel, el agente director.
- Si el producto es material (un borrador, un resumen, una ordenación), quédate en el medio. Informe, bandeja, contenido y tesorero funcionan así.
- Si el producto es una comprobación contra reglas fijas, baja. O quítale el modelo: un script en el cron gana a cualquier agente cuando la regla se puede formalizar. La revisión de publishers es medio script.
Dos añadidos que nos han ahorrado dinero. Primero: lo determinista gana a cualquier modelo. Antes de cada paso con modelo comprobamos si una consulta, un filtro o un script da lo mismo. Segundo: subir de modelo solo con prueba. No "esto parece complejo", sino "esta ejecución se saltó X, aquí está el sitio". Si no, todo el equipo sube de categoría y la factura con él.
Dónde se rompió
Un equipo que lleva tres meses tiene historial de averías. El nuestro, en tres puntos, porque explican las reglas de construcción.
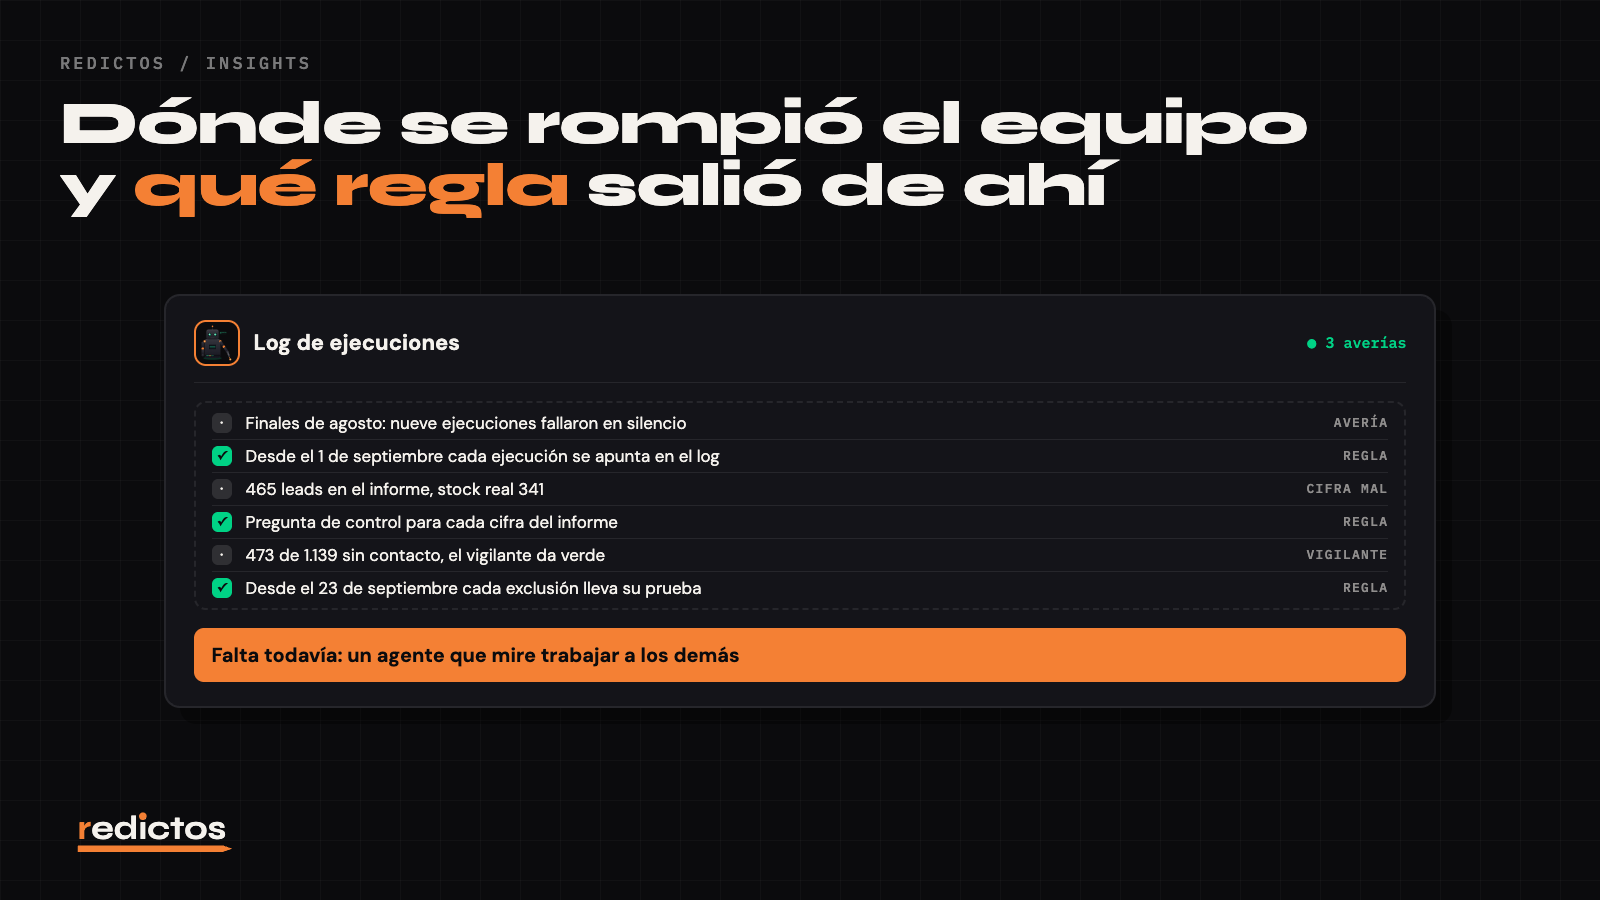
Nueve ejecuciones que fallaron en silencio. El informe matinal funcionó en verano como piloto. A finales de agosto falló nueve días seguidos y nadie se dio cuenta, porque un agente que no escribe tampoco escribe un mensaje de error. Desde el 1 de septiembre cada ejecución tiene obligación de informar: se apunta en un log con marca de tiempo, aunque no haya encontrado nada. Las 24 ejecuciones seguidas solo se pueden contar desde esa regla.
Una cifra que estuvo mal tres días. El informe muestra el stock de leads de las campañas. El 28 de septiembre marcaba 465 leads aprobados. 124 de ellos estaban en campañas pausadas y no podían enviarse. El stock real era 341. El error apareció cuando introdujimos una pregunta de control para cada cifra del informe: ¿qué tendría que hacer alguien todavía para que este número sea cierto? Un agente cuenta bien. Lo que no sabe es qué cuenta.
Un vigilante que cada día decía "todo en orden". Un agente de control debía avisar de contactos de publishers desactualizados y excluía toda una categoría, porque en el código había una excepción cuya justificación ya no era válida. Resultado: de 1.139 registros de esa categoría, 473 llevaban más de doce meses sin contacto, y el vigilante daba verde a diario. Desde el 23 de septiembre cada regla de exclusión de un vigilante tiene que llevar su propia prueba de cuándo se revisó por última vez.
La lección de los tres casos: un equipo de agentes no necesita un prompt mejor. Necesita un agente que mire trabajar a los demás y avise cuando la misma corrección hace falta por tercera vez.
La estructura inicial para mañana
No necesitas un framework ni una plataforma. Necesitas una carpeta, seis entradas dentro y una tarea programada.
- reglas.md: quién decide y qué no sale nunca sin aprobación.
- contexto/: perfil de cliente, tono, frases de prueba con fuente. Lo que cada agente lee antes de trabajar.
- agentes/informe.md: disparador, fuentes, formato de salida, obligación de informar. Un archivo por papel.
- bandeja/: tarjetas con opciones que decide una persona.
- decisiones/: tarjetas respondidas, con fecha y motivo.
- log.md: una línea por ejecución, también cuando "no se encontró nada".
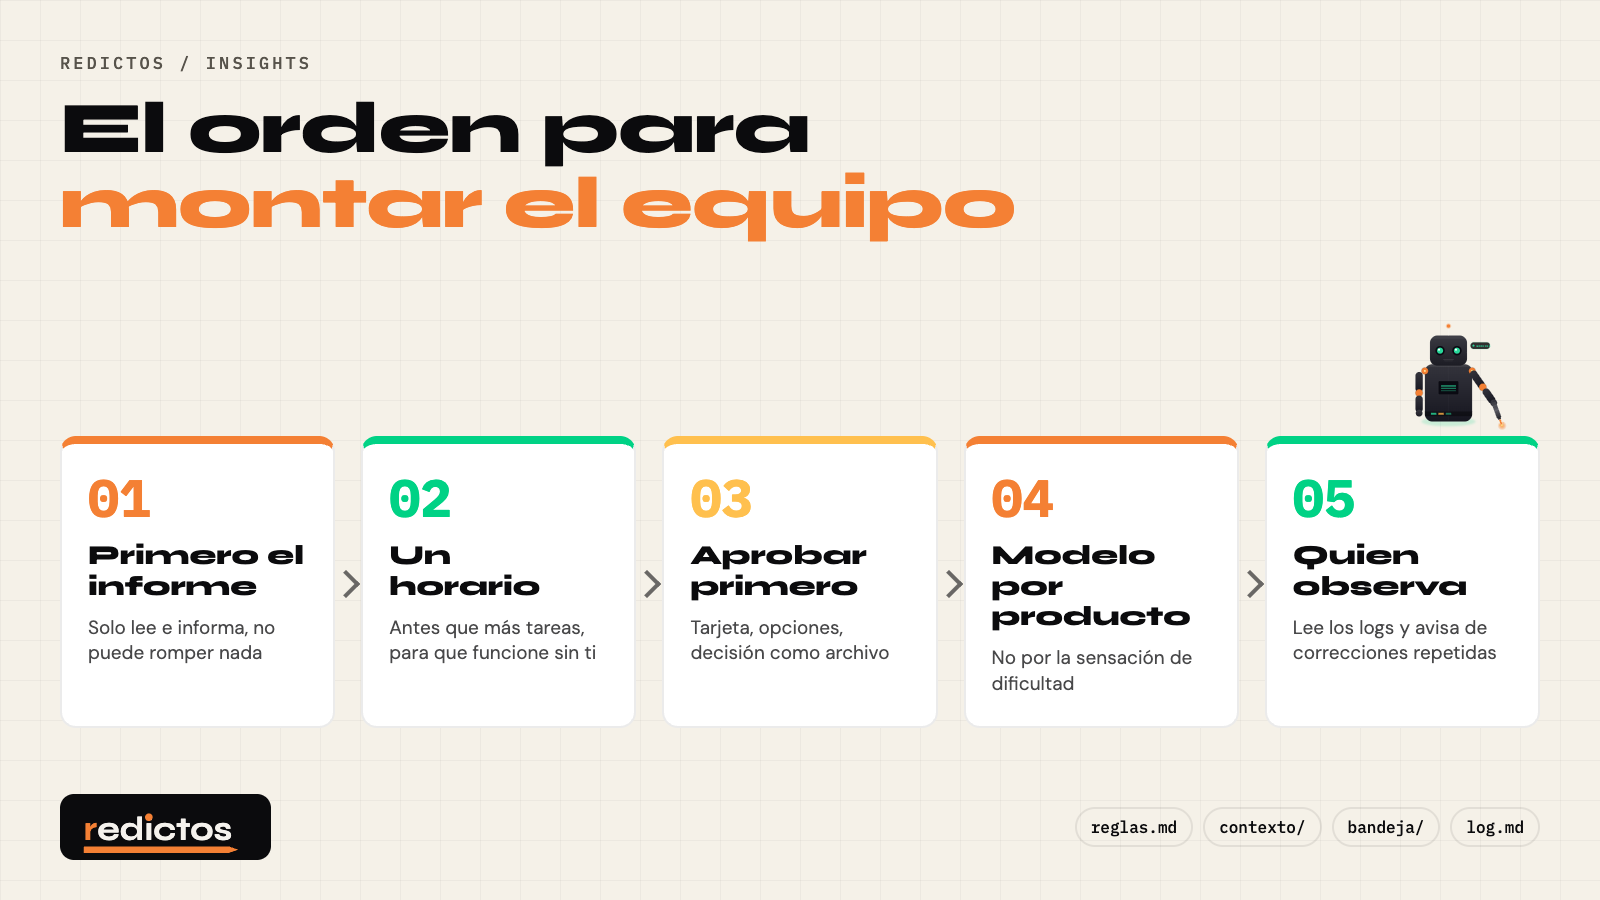
Y el orden para montar el equipo:
- Empieza por el informe, no por la venta. Un agente que solo lee e informa no puede romper nada. Con él aprendes cómo tiene que ser tu carpeta de contexto.
- Dale un horario antes de darle más tareas. Solo cuando funciona sin ti es parte del equipo.
- Escribe la regla de aprobación antes de que el primer agente pueda enviar algo. Tarjeta, opciones, decisión como archivo. Es la única regla que nunca hemos relajado.
- Elige el modelo según el producto de la ejecución, no según la sensación de dificultad.
- Monta el observador en segundo lugar. Un agente cuya única tarea es leer el log de los demás y avisar de correcciones repetidas.
Lo que todavía no tenemos es el observador. Está como pregunta abierta en nuestras notas desde el 31 de agosto. Cuando funcione, contaré qué encontró en la primera semana.